步骤 1
准备输入文件
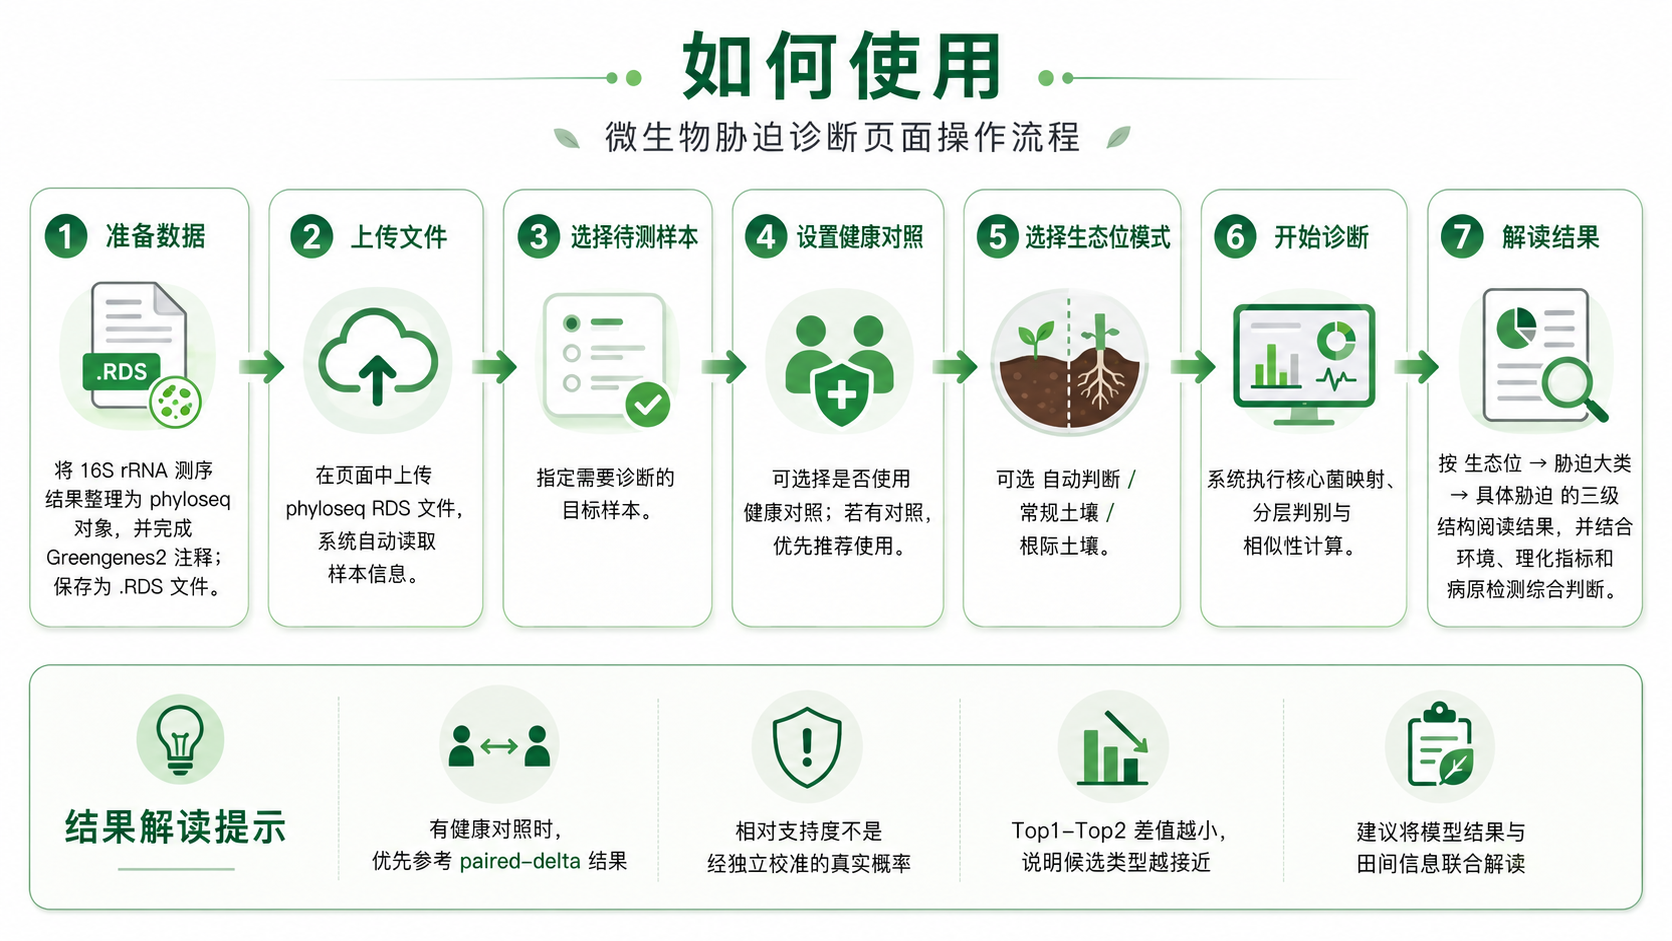
准备已完成 Greengenes2 注释的 phyloseq .rds 对象。对象应包含 otu_table 和 tax_table,并能够获得属水平(Genus)注释。系统会自动聚合并提取参考库中的全球核心细菌属。
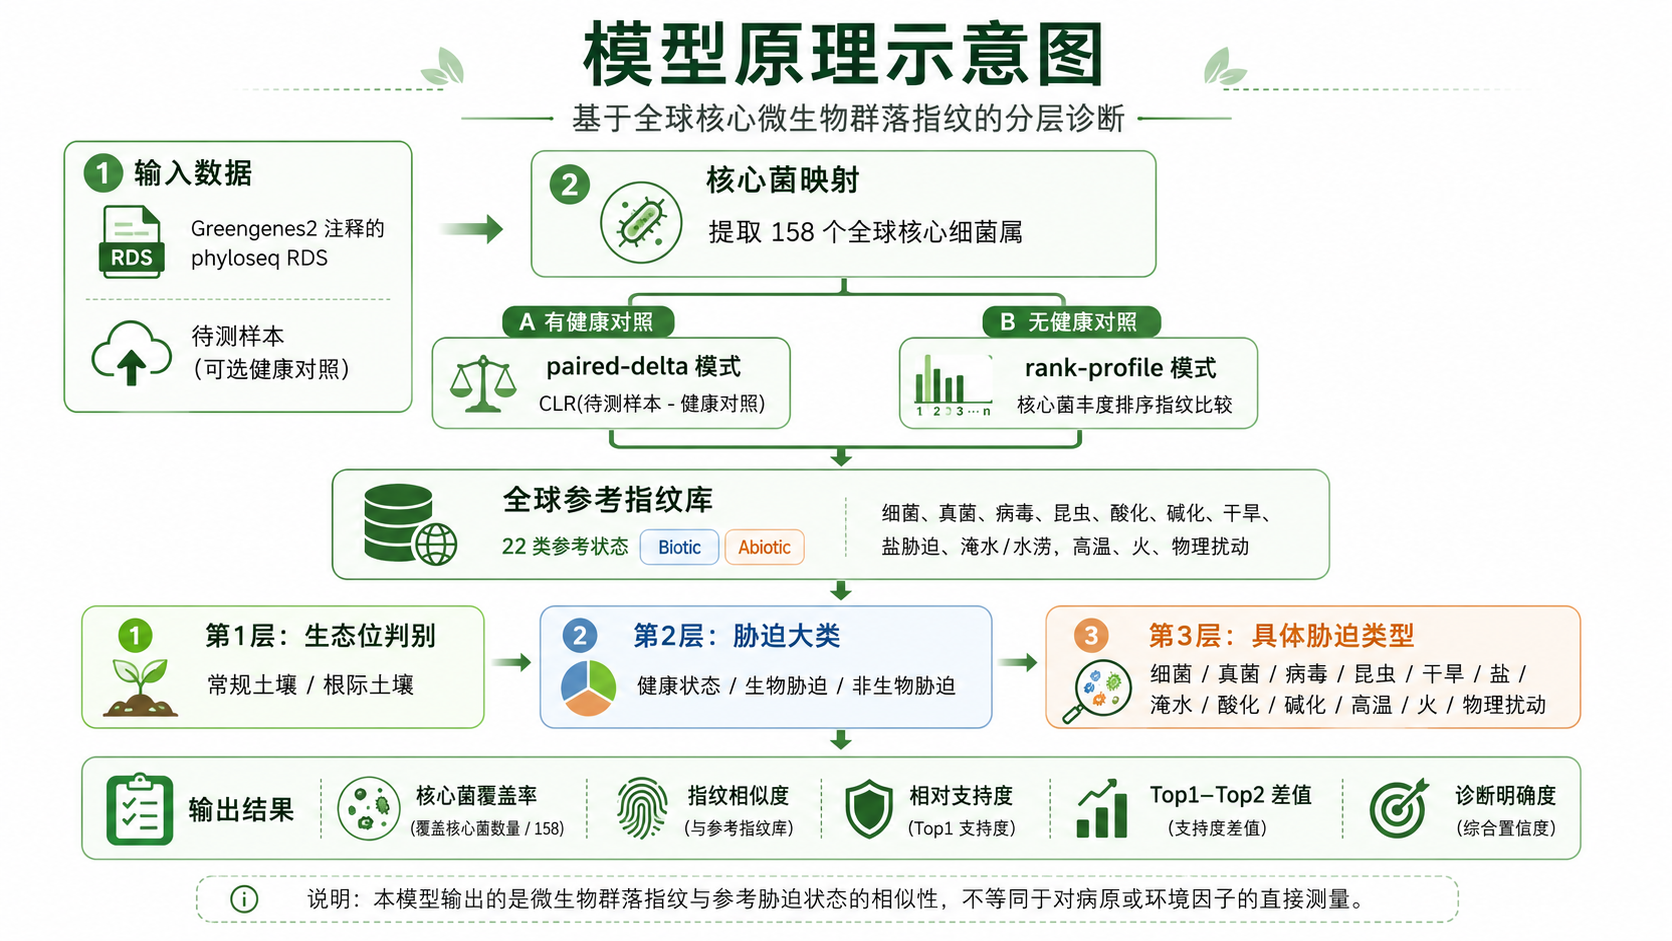
基于全球30万余份土壤与根际微生物群落筛选形成的核心细菌群落指纹,对未知样本进行生态位与胁迫类型匹配。支持普通土壤、根际土壤自动判断, 并识别干旱、盐胁迫、高温、淹水、酸碱变化、物理扰动及多类生物胁迫。
上传已经完成 Greengenes2 注释的 phyloseq RDS 对象。
指定待测样本、是否使用匹配健康对照,以及样本生态位信息。
按照下面 6 个步骤完成从数据上传到结果解读。若具有同来源、同批次的健康样本,建议优先采用“健康对照差异模式”,以降低样本背景差异对诊断的影响。
准备已完成 Greengenes2 注释的 phyloseq .rds 对象。对象应包含 otu_table 和 tax_table,并能够获得属水平(Genus)注释。系统会自动聚合并提取参考库中的全球核心细菌属。
点击上传或拖入 RDS 文件。系统会自动读取样本名称、注释来源,并提取可用于诊断的属水平群落数据。
在“待测样本”中选择需要诊断的单个样本。如果一个 RDS 中有多个重复或多个处理,可以逐个样本分别诊断。
若有合理匹配的健康对照,建议优先使用。 系统将比较“待测样本 − 健康对照”的 CLR 差异指纹;没有合适对照时,则直接比较待测样本的核心菌丰度排序指纹。
若明确知道样本来自普通土壤或根际土壤,可直接指定;若不确定,则选择“自动判断”,模型会先比较更像 Soil 还是 Rhizosphere。
按照“生态位 → 胁迫大类 → 具体胁迫”三层结构解读,同时关注核心菌覆盖率、指纹相似度、相对支持度和 Top1–Top2 差值。若候选差值较小,应按“低明确度 / 可能复合胁迫或参考库未覆盖状态”谨慎解释。
从 phyloseq RDS 输入开始,经过全球核心菌映射、两种匹配模式和三级分层判定,最终输出候选胁迫及诊断明确度。